一つの脳インプラントで発話とジェスチャーを同時に読み取り、アバターを操作
まひのある参加者の実験で、二つの伝達手段を同時に解読した。組み合わせた試みを使う学習が重要で、対応できる表現はまだ限られている。
Leitura autorizada · 3 crédito(s) restante(s)
あいさつでは、言葉と手を振る動作を同時に使う。しかし脳とコンピューターをつなぐインターフェースに両方を認識させるには、別々に動く二つのプログラムを単に組み合わせるだけでは足りない。カリフォルニア大学サンフランシスコ校のチームは、一つのインプラントから得た信号で発話とジェスチャーを並行して解読し、利用者のデジタル分身を操作できることを示した。Samantha Brosler、Jessie Liu、Alexander Silvaらの研究は9月14日、Nature Neuroscienceに掲載された。選択肢をあらかじめ決めた課題での実証であり、制限のない会話とはまだ隔たりがある。
研究者らは、程度の異なるまひがある3人の脳活動を記録した。それぞれの脳表面に253個の電極を備えた格子を置き、発話や運動に関わる領域を覆った。皮質脳波記録と呼ばれるこの方法は、神経細胞集団の電気信号を捉える。アバターの実演と発話・ジェスチャーを組み合わせる課題には2人が参加した。1人は脳幹の脳卒中後にまひが生じ、もう1人は運動を担う神経細胞が障害される筋萎縮性側索硬化症を患っていた。
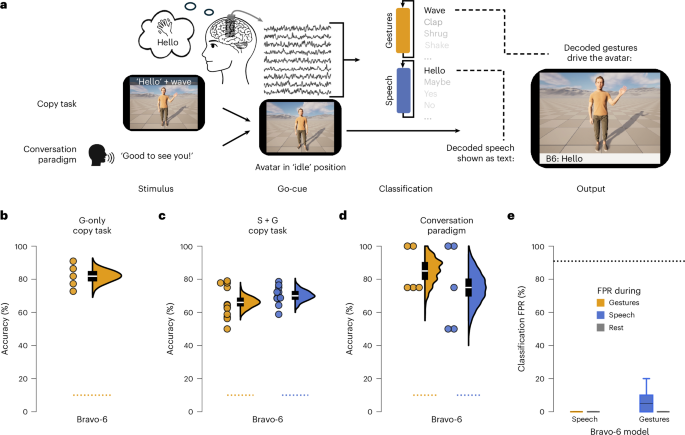
画面上の合図に従う試行で、参加者は能力に応じて、短い言葉を発しようとしたり、ジェスチャーを行おうとしたり想像したり、両方を組み合わせたりした。同じインプラントの信号を二つの機械学習モデルが受け取り、一方は発話を、もう一方はジェスチャーを分類した。認識された発話は文字になり、アバターは手を振る、頭を動かすなど、選ばれた動作を実行した。命令が送られたのはデジタルの身体であり、実験でまひした身体の運動が回復したわけではない。
難しさが現れたのは、発話だけ、あるいはジェスチャーだけで学習したモデルが、同時の試みを解読するときだった。一部の電極は両方の行動に反応し、組み合わせた際の活動パターンは同じようには認識されなかった。同時に試みる例を学習に加えると、性能が改善した。さらに、もう一方の行動だけがある場合には出力しないよう各モデルを学習させた。例えば発話の分類器には、手を振るだけの試みを言葉に変換しないことを教えた。
筋萎縮性側索硬化症の参加者によるリアルタイムの同時課題では、発話の70%、ジェスチャーの66%を正しく識別した。各10種類の選択肢に加え、モデルには休息のクラスもあった。推定の不確かさを示す95%信頼区間は、発話が63.5~76%、ジェスチャーが59.5~72.5%だった。11クラスから無作為に選ぶ場合の基準値は約9.1%である。二つは別々の指標で、試行の70%で発話とジェスチャーが両方正しかったという意味ではない。
主な成果は、コミュニケーションの中で共存する行動に対応するインターフェースの学習方法を示したことだ。ジェスチャーは言葉を補い、単独でも返答となり、アバターで表現できる内容を広げる。日常の道具にするには、対応する表現を増やし、応答の遅れを減らし、より多くの人で性能を確かめる必要がある。今回のシステムは、インプラントと外部機器を結ぶ有線接続にも依存している。
要点
- 一つのインプラントの信号で発話とジェスチャーを並行して解読し、2人がアバターを使用した。
- 発話10種類とジェスチャー10種類を使う同時課題で、1人の正答率はそれぞれ70%と66%だった。
- 複合動作での学習は干渉を減らしたが、表現数、参加者数、機器が日常利用を制限している。
コメント
公開済みのコメントはまだありません。
購読アカウントでログインするとコメントできます。