एक मस्तिष्क इम्प्लांट बोलने और इशारों को साथ पढ़कर अवतार चलाता है
पक्षाघात वाले प्रतिभागियों के प्रयोग में संचार के दो तरीकों को एक साथ डिकोड किया गया। इसके लिए संयुक्त प्रयासों पर मॉडल का प्रशिक्षण जरूरी था; पहचानी जाने वाली अभिव्यक्तियाँ अभी सीमित हैं।
Leitura autorizada · 3 crédito(s) restante(s)
अभिवादन में एक शब्द और हाथ हिलाने का इशारा साथ आ सकते हैं, लेकिन मस्तिष्क इंटरफेस को दोनों एक साथ पहचानना सिखाना, अलग-अलग काम करने वाले दो प्रोग्राम जोड़ने जितना सरल नहीं है। कैलिफोर्निया विश्वविद्यालय, सैन फ्रांसिस्को की एक टीम ने दिखाया कि एक ही इम्प्लांट से मिले संकेतों के आधार पर बोलने और इशारों को समानांतर डिकोड करके उपयोगकर्ता के डिजिटल रूप को नियंत्रित किया जा सकता है। Samantha Brosler, Jessie Liu, Alexander Silva और सहयोगियों का अध्ययन 14 सितंबर को Nature Neuroscience में प्रकाशित हुआ। यह उपलब्धि पहले से तय विकल्पों वाले कार्यों में दिखाई गई है और अभी बिना प्रतिबंध वाली बातचीत से काफी दूर है।
शोधकर्ताओं ने अलग-अलग स्तर के पक्षाघात वाले तीन लोगों की मस्तिष्क गतिविधि दर्ज की। प्रत्येक व्यक्ति के मस्तिष्क की सतह पर 253 इलेक्ट्रोड वाली जाली लगाई गई थी, जो बोलने और गतिविधियों से जुड़े क्षेत्रों को ढकती थी। इलेक्ट्रोकॉर्टिकोग्राफी नामक यह तकनीक न्यूरॉनों के समूहों से विद्युत संकेत दर्ज करती है। अवतार के प्रदर्शन और बोलने-इशारा करने के संयुक्त कार्यों में दो प्रतिभागी शामिल थे: एक को मस्तिष्क-तने में स्ट्रोक के बाद पक्षाघात हुआ था; दूसरे को एमियोट्रोफिक लेटरल स्क्लेरोसिस था, जो गतिविधि नियंत्रित करने वाले न्यूरॉनों को नुकसान पहुँचाने वाला रोग है।
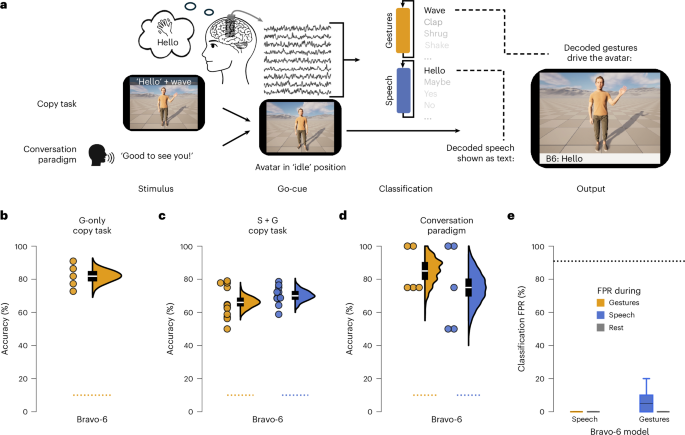
स्क्रीन पर संकेतों से निर्देशित प्रयासों में प्रतिभागी अपनी क्षमता के अनुसार वाक्यांश बोलने, इशारे करने या उनकी कल्पना करने, अथवा दोनों क्रियाएँ साथ करने की कोशिश करते थे। मशीन लर्निंग के दो मॉडल एक ही इम्प्लांट के संकेत लेते थे: एक वाक्यांशों का वर्गीकरण करता था और दूसरा इशारों का। पहचाना गया वाक्यांश लिखित रूप में दिखता था, जबकि अवतार हाथ हिलाता, सिर घुमाता या कोई अन्य चुना गया इशारा करता था। आदेश डिजिटल शरीर के लिए था; प्रयोग ने पक्षाघात वाले शरीर की गतिविधियाँ वापस नहीं लौटाईं।
समस्या तब सामने आई जब केवल अलग-अलग बोलने या इशारा करने के प्रयासों पर प्रशिक्षित मॉडलों को संयुक्त प्रयास समझने पड़े। कुछ इलेक्ट्रोड दोनों व्यवहारों पर प्रतिक्रिया देते थे, और संयुक्त प्रयासों के दौरान दर्ज पैटर्न उतनी प्रभावशीलता से पहचाने नहीं जाते थे। प्रशिक्षण में एक साथ किए गए प्रयासों के उदाहरण जोड़ने से प्रदर्शन सुधरा। एक अन्य बदलाव ने हर मॉडल को सिखाया कि केवल दूसरी तरह की क्रिया होने पर उत्तर न दे: मसलन, बोलने वाले वर्गीकरण मॉडल ने सीखा कि सिर्फ हाथ हिलाने की कोशिश को वाक्यांश नहीं बनाना चाहिए।
एमियोट्रोफिक लेटरल स्क्लेरोसिस वाले प्रतिभागी के वास्तविक समय के संयुक्त परीक्षण में प्रणाली ने 70% वाक्यांश और 66% इशारे सही पहचाने। दोनों प्रकार में दस-दस विकल्प थे और मॉडल में विश्राम की एक अतिरिक्त श्रेणी भी थी। अनुमानों की अनिश्चितता बताने वाले 95% विश्वास अंतराल बोलने के लिए 63.5% से 76% और इशारों के लिए 59.5% से 72.5% थे। ग्यारह श्रेणियों में यादृच्छिक चुनाव का संदर्भ स्तर लगभग 9.1% था। ये अलग-अलग माप हैं: इनका अर्थ यह नहीं कि 70% प्रयासों में वाक्यांश और इशारा दोनों सही थे।
मुख्य योगदान यह दिखाना है कि संचार में साथ मौजूद व्यवहारों के लिए इंटरफेस को कैसे प्रशिक्षित किया जाए। इशारा किसी वाक्यांश को पूरा कर सकता है या अपने आप उत्तर बन सकता है, जिससे अवतार के जरिए अभिव्यक्ति की संभावनाएँ बढ़ती हैं। इस प्रदर्शन को रोजमर्रा का उपकरण बनाने के लिए अधिक अभिव्यक्तियाँ जोड़नी होंगी, उत्तर मिलने में लगने वाला समय घटाना होगा और अधिक लोगों में प्रदर्शन जाँचना होगा। अध्ययन की प्रणाली इम्प्लांट और बाहरी उपकरणों के बीच तार वाले कनेक्शन पर भी निर्भर थी।
मुख्य बिंदु
- एक इम्प्लांट ने बोलने और इशारों के समानांतर डिकोडिंग के संकेत दिए; दो प्रतिभागियों ने अवतार इस्तेमाल किया।
- दस वाक्यांशों और दस इशारों वाले संयुक्त परीक्षण में एक प्रतिभागी की सटीकता क्रमशः 70% और 66% रही।
- संयुक्त क्रियाओं पर प्रशिक्षण से हस्तक्षेप घटा, लेकिन अभिव्यक्तियों, नमूने और उपकरणों की सीमाएँ दैनिक उपयोग रोकती हैं।
टिप्पणियाँ
अभी कोई प्रकाशित टिप्पणी नहीं है।
टिप्पणी के लिए सदस्यता खाते से प्रवेश करें।