Un implante cerebral combina habla y gestos para controlar un avatar
Un experimento con personas con parálisis decodificó dos formas de comunicación a la vez. El avance dependió de entrenar los modelos con intentos combinados y aún utiliza repertorios limitados.
Leitura autorizada · 3 crédito(s) restante(s)
Un saludo puede reunir una palabra y un movimiento de la mano, pero enseñar a una interfaz cerebral a reconocer ambos a la vez no consiste simplemente en unir dos programas que funcionan por separado. Un equipo de la Universidad de California en San Francisco mostró que un solo implante puede proporcionar señales para decodificar habla y gestos en paralelo y controlar una representación digital del usuario. Publicado el 14 de septiembre en Nature Neuroscience, el estudio de Samantha Brosler, Jessie Liu, Alexander Silva y sus colegas demuestra esta posibilidad en tareas con opciones predefinidas, todavía lejos de una conversación sin restricciones.
Los investigadores registraron la actividad cerebral de tres personas con distintos grados de parálisis. En cada una, una malla de 253 electrodos descansaba sobre la superficie cerebral, abarcando regiones relacionadas con el habla y los movimientos. Esta técnica, llamada electrocorticografía, capta señales eléctricas de poblaciones de neuronas. Las demostraciones con el avatar y las tareas que combinaban habla y gestos involucraron a dos participantes: uno con parálisis tras un accidente cerebrovascular en el tronco encefálico y otro con esclerosis lateral amiotrófica, enfermedad que afecta a las neuronas responsables del movimiento.
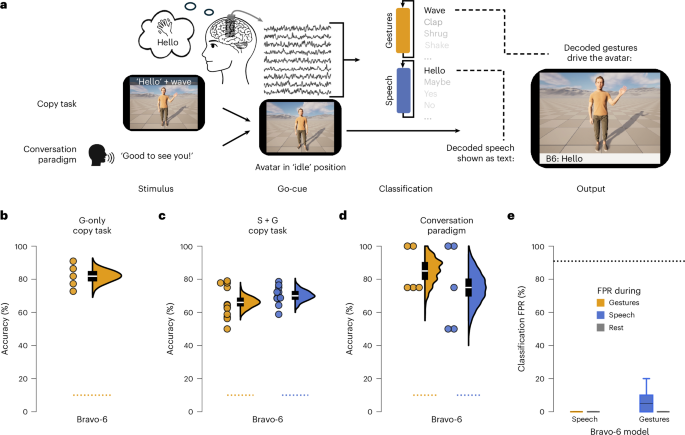
En ensayos guiados por señales en pantalla, los participantes intentaban producir frases, realizar o imaginar gestos, o combinar ambas acciones, según sus capacidades. Dos modelos de aprendizaje automático recibían las señales del mismo implante: uno clasificaba frases y el otro, gestos. La frase reconocida aparecía como texto, mientras el avatar saludaba con la mano, movía la cabeza o ejecutaba otro gesto seleccionado. La orden se dirigía al cuerpo digital; el experimento no recuperó los movimientos del cuerpo paralizado.
La dificultad apareció cuando los modelos entrenados únicamente con habla aislada o gestos aislados tuvieron que interpretar intentos simultáneos. Parte de los electrodos respondía a ambos comportamientos, y los patrones registrados durante la combinación no se reconocían con la misma eficacia. Incluir ejemplos simultáneos en el entrenamiento mejoró el rendimiento. Otro ajuste enseñó a cada modelo a no responder cuando solo estaba presente la otra modalidad: por ejemplo, el clasificador del habla aprendió que un intento aislado de saludar con la mano no debía convertirse en una frase.
En la prueba simultánea en tiempo real con el participante con esclerosis lateral amiotrófica, el sistema identificó correctamente el 70% de las frases y el 66% de los gestos, entre diez alternativas de cada tipo, además de la clase de reposo. Los intervalos de confianza del 95%, que expresan la incertidumbre de estas estimaciones, fueron del 63,5% al 76% para el habla y del 59,5% al 72,5% para los gestos. La selección aleatoria entre las once clases ofrecía una referencia aproximada del 9,1%. Son medidas separadas: no significan que frase y gesto fueran ambos correctos en el 70% de los ensayos.
La contribución central es mostrar cómo entrenar una interfaz para comportamientos que coexisten en la comunicación. Un gesto puede complementar una frase o constituir una respuesta por sí mismo, ampliando lo que permite expresar un avatar. Para convertir esta demostración en una herramienta cotidiana, será necesario ampliar los repertorios, reducir la demora de las respuestas y comprobar el rendimiento en más personas. El sistema estudiado también depende de una conexión por cables entre el implante y equipos externos.
Puntos esenciales
- Un solo implante proporcionó señales para decodificar habla y gestos en paralelo; dos participantes utilizaron el avatar.
- En la prueba simultánea con diez frases y diez gestos, un participante logró un 70% y un 66% de acierto, respectivamente.
- Entrenar con acciones combinadas redujo interferencias, pero el repertorio, la muestra y los equipos aún limitan el uso cotidiano.
Comentarios
Aún no hay comentarios publicados.
Inicie sesión con una suscripción para comentar.